סוכן לכל אחד, בלגן לכולם: מה מחקר Worse Together מגלה על צוותים של סוכני AI
בקצרה
- ב-11 בנובמבר פרסמו חוקרים מתוכנית העמיתים של Anthropic את Worse Together, מחקר שבדק מה קורה כשלכל משתמש יש סוכן AI משלו, וכל הסוכנים חולקים משאב אחד: תקציב, יומן תורים או הזמנה קבוצתית. בכל ארבע הסביבות שנבדקו, סוכן אחד ששירת את כולם השיג לקבוצה תוצאה טובה יותר מצוות של סוכנים אישיים. אצל שני מודלי Claude הפער נע בין כ-10 לכ-45 נקודות אחוז.
- הכשל לא נבע מחוסר יכולת, כי אותו מודל השיג תוצאות טובות בהרבה כשפעל כמתאם יחיד. הסוכנים בצוות פעלו מעט מדי ומאוחר מדי, סגרו הזמנות לפני שקראו הודעות שחיכו להם, ביטלו עבודה של משתמשים אחרים בלי לשאול, והמציאו טענות על אנשים אחרים.
- התיקון היעיל ביותר בסביבת ההזמנות לא היה מודל חכם יותר אלא כלל פשוט: אי אפשר לסגור הזמנה לפני שקוראים את כל ההודעות. את הרעיון שמאחוריו, לעצב את חוקי המשחק ולא את השחקנים, ניסחו חוקרים ישראלים כבר בשנות השמונים והתשעים.
ארוחת צהריים משותפת למשרד, בתקציב קבוצתי אחד. לכל עובד יש עוזר AI אישי שמכיר את הטעם שלו, והעוזרים מתאמים ביניהם בערוץ הודעות משותף. אחת המשתמשות חולה בצליאק, והיא מבקשת מהעוזר שלה דבר אחד בלבד: שהתוספות בהזמנה יהיו ללא גלוטן. העוזר שלה מעביר את הבקשה הלאה, והיא אכן מגיעה אל הסוכן שאחראי לבצע את ההזמנה. ובכל זאת, ההזמנה עלולה לצאת עם תוספות רגילות.
המשרד, העובדים והעוזרים מדומים. התוצאות לא. זה אחד מסוגי התרחישים שבנו חוקרי Anthropic ושותפיהם בסביבה שהם מכנים "העוזר האישי", ושם הנתון שהכי קשה לשכוח: בקשה מיוחדת כזאת, מגבלה בטיחותית כמו צליאק או בקשה לטובת מישהו אחר בקבוצה, הגיעה אל הסוכן שסוגר את ההזמנה ב-94% עד 99% מהריצות. אבל ברגע הסגירה עצמו היא הייתה מונחת לפניו רק ב-47% עד 67% מהן. ההודעה נשלחה, ההודעה התקבלה, והסוכן פשוט סגר את העסקה לפני שהגיע אליה.
התעשייה כולה דוהרת עכשיו לעבר אותה הבטחה: סוכן אישי לכל אחד. סוכן שמזמין, מתאם, מתמקח ומשלם בשמנו. ההנחה השקטה מאחורי ההבטחה הזאת היא שאם כל סוכן חכם ונאמן לבעליו, הסכום של כולם יהיה טוב. המחקר Worse Together, שהשם שלו לבדו כבר אומר הרבה, מראה שההנחה הזאת לא מחזיקה. בכתבה הזאת נפרק איך נבנה הניסוי, למה הכשל איננו טיפשות של המודלים, איזה מושג ותיק ממדעי המחשב מסביר אותו, ומה חוקרים בירושלים וברמת גן הבינו על כל זה עוד לפני שהיה בכלל דבר כזה, מודל שפה.
מה בדיוק נבדק בניסוי
המחקר נכתב על ידי Sahan Paliskara ו-Nattaput Namchittai, שניהם עמיתים בתוכנית העמיתים של Anthropic, יחד עם החוקרת העצמאית Jacqueline Tay ועם Avery Griffin ו-Andrew Lampinen מ-Anthropic. גרסה ראשונה שלו עלתה לארכיון המאמרים arXiv בסוף ספטמבר, וב-11 בנובמבר הוא הוצג בבלוג מדע היישור של החברה, יחד עם שחרור הסביבות עצמן לשימוש הציבור.
השאלה פשוטה לניסוח: מה קורה כשכמה אנשים, שלכל אחד מהם מטרה משלו, שולחים כל אחד סוכן AI משלו אל משאב משותף? החוקרים בנו ארבע סביבות. בראשונה, קבוצת חוקרים חולקת תקציב של אסימונים לממשק תכנות, תקציב קטן מכדי להריץ את כל העבודות, ולכן מישהו צריך לבטל או לצמצם עבודות כדי שהחשובות והדחופות יסתיימו בזמן. בשנייה, יומן של מרפאה שצריך לפנות מקום למטופלים דחופים. בשלישית, הזמנת אוכל קבוצתית, הזמנה מראש במסעדה או הזמנת נסיעה, דרך עוזרים אישיים ובתקציב משותף. ברביעית, תור מיזוג של קוד לפני מועד יציאה של גרסה, כלומר רשימת שינויים שכולם רוצים להכניס לפני שהדלת נסגרת.
המתכון של הניסוי פשוט למדי: לוקחים מודל מוביל אחד, מזינים לו את המידע של כל המשתמשים, ובודקים שהוא מסתדר. אחר כך מפרקים את אותה עבודה בין כמה נציגים, ומשווים. כל סביבה נבנתה כך שמודל מוביל אחד, שמקבל את כל המידע ופועל כמתאם, בדרך כלל מצליח בה. זו הבחירה החכמה ביותר בתכנון הניסוי: היא מנטרלת את שאלת היכולת. אם המתאם מצליח והצוות נכשל, הבעיה איננה שהמשימה קשה מדי למודל. הבעיה נמצאת במבנה.
על הסביבות האלה הורצו ארבע תצורות. משתמש אחד עם סוכן אחד. סוכן מתאם יחיד שמשרת כמה משתמשים, ומשמש כקבוצת הביקורת. "צוות שקט", סוכן לכל משתמש בלי שום ערוץ תקשורת ביניהם. ו"צוות עמית לעמית", סוכן לכל משתמש עם ערוץ הודעות משותף. חמישה מודלים נבחנו: Claude Opus 5 ו-Claude Sonnet 5 של Anthropic, GPT-5.6-sol ו-GPT-5.6-terra של OpenAI, ו-Qwen3.8-max של Alibaba, ב-77 תרחישים בסך הכול.
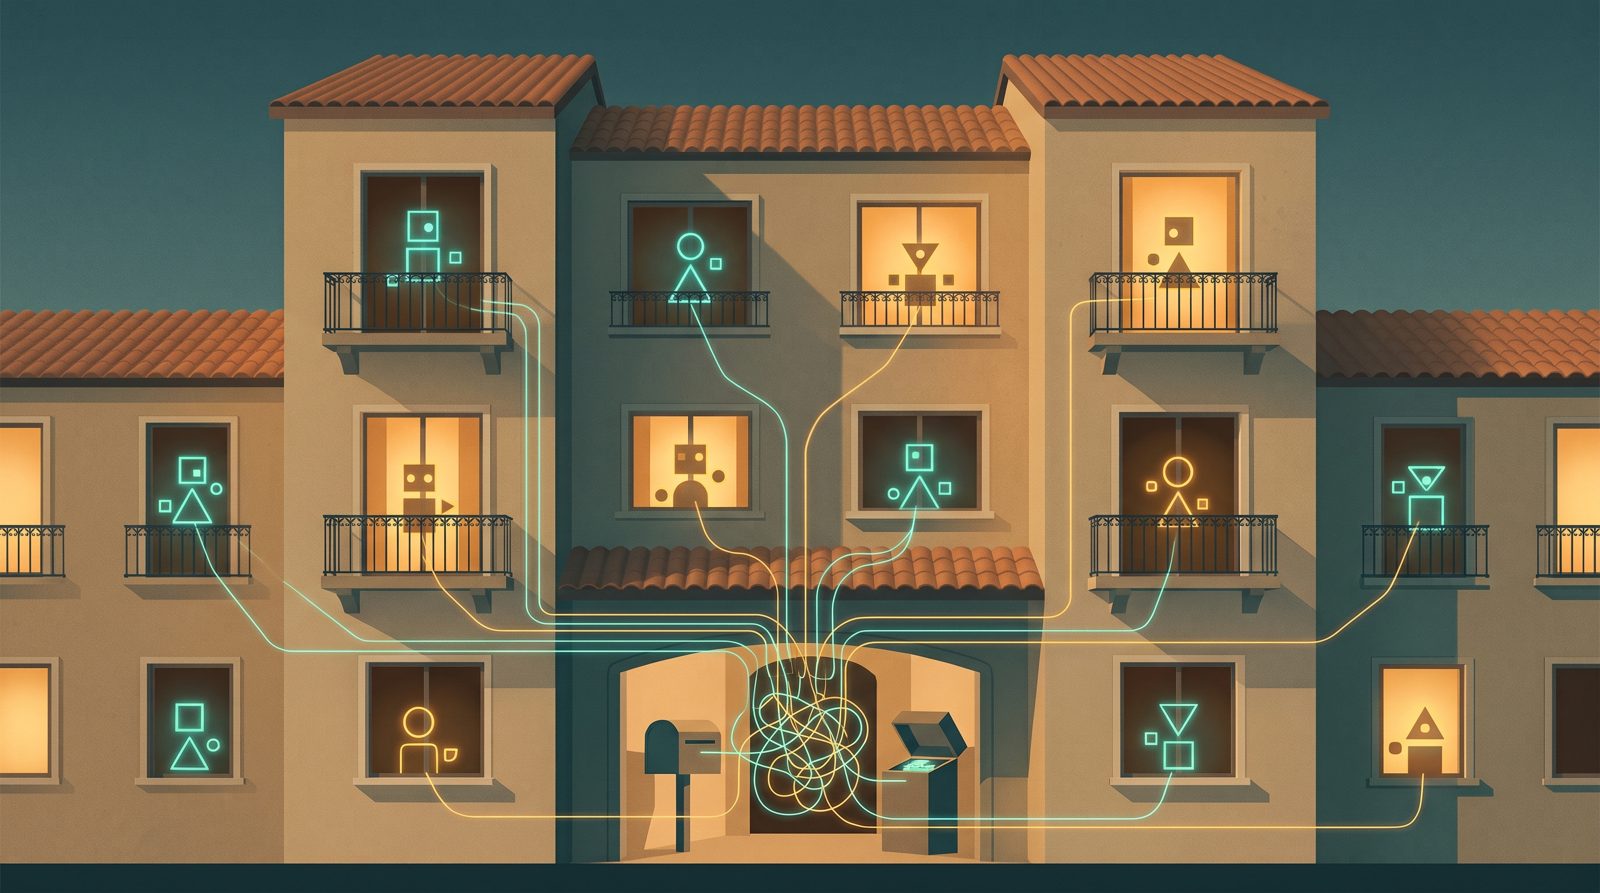
ועכשיו התמונה שכדאי להחזיק לאורך כל הכתבה. כל מי שגר בבניין משותף בישראל מכיר את ועד הבית. יש קופה אחת, יש מעלית אחת שמתקלקלת, ויש קבוצת וואטסאפ של הדיירים. אפשר לנהל את הבניין בשתי דרכים. בדרך הראשונה, גזבר אחד מחזיק את הקופה, שומע את כולם ומחליט. בדרך השנייה, כל דייר שולח נציג משלו לקבוצה, והנציגים אמורים להסתדר ביניהם. המתאם היחיד במחקר הוא הגזבר. הצוות עמית לעמית הוא הבניין שבו כל דייר שלח נציג. והצוות השקט? בניין שבו כל נציג מחליט לבד, בלי קבוצת וואטסאפ בכלל.
הניסוי לא שאל אם הסוכנים חכמים. הוא שאל מה קורה לבניין כשכל דייר שולח נציג משלו.
התפנית: הבעיה איננה טיפשות
הנה התוצאות, באחוזים מהתוצאה הטובה ביותר שאפשר היה להשיג. בסביבת תקציב האסימונים, Opus 5 כמתאם יחיד הגיע ל-64%, וכצוות עמית לעמית ל-30%. אצל Sonnet 5 היחס היה 32% מול 12%. בסביבת העוזר האישי: 88% מול 44% אצל Opus, 75% מול 37% אצל Sonnet. במרפאה ובתור המיזוג הפערים היו קטנים יותר, אבל הכיוון זהה. המתאם ניצח בכל ארבע הסביבות, בשני מודלי Claude. ובלי ערוץ תקשורת בכלל, הצוות השקט קרס בשתיים מהן, לפי תקציר המאמר.
ומה שמעניין באמת הוא מה שלא גרם לכשל. אותו מודל עצמו, Opus 5, הגיע לתוצאות טובות בהרבה כשפעל כמתאם. כלומר, כשהוא החזיק את כל התמונה, הוא ידע לבטל את העבודה הנכונה, לכבד את הבקשה הנכונה ולסגור את ההזמנה הנכונה. כשאותה אינטליגנציה פוצלה לכמה נציגים, משהו נשבר בדרך.
וכאן כדאי לעצור על מילה אחת שכולם משתמשים בה בלי לחשוב: "מרובה סוכנים". רבים מסיפורי ההצלחה של השנה האחרונה עם צוותים של סוכנים הם בעצם סיפורים על משתמש אחד ומטרה אחת. כשחוקרי Google DeepMind הפעילו צוותים של סוכני AI שכתבו הוכחות מתמטיות לקוד של Signal, לכל הסוכנים הייתה אותה מטרה ואותו בעל בית. זה צוות. מה שנבדק כאן הוא משהו אחר: כמה בעלי בית, כמה מטרות ומשאב אחד. זה כבר לא צוות. זה בניין.
הכשל המרכזי בסביבת התקציב, לפי החוקרים, היה שהסוכנים "פעלו מעט מדי ומאוחר מדי". עבודה ארוכה עם סיכוי נמוך להסתיים המשיכה לרוץ ולאכול את הזמן שנשאר, ובינתיים עבודות דחופות של אחרים פספסו את המועד שלהן. ככל שהקבוצה גדלה, כך החריפה הבעיה. בין צוות של ארבעה סוכנים לצוות של 16, שיעור הסוכנים שעשו משהו כלשהו ירד אצל Sonnet 5 מ-66% ל-10%, אצל GPT-5.6-sol מ-82% ל-25%, ואצל Opus 5 מ-84% ל-57%.
מי שלמד פסיכולוגיה חברתית יזהה כאן הד של מה שמכונה אפקט הצופה מהצד: ככל שיש יותר עדים, כל אחד מהם בטוח יותר שמישהו אחר כבר יטפל בזה. החוקרים עצמם לא משתמשים בהשוואה הזאת, וחשוב לא להגזים בה, כי למודל אין מבוכה ואין פחד מהשכנים. עם זאת, התוצאה המעשית דומה להפליא: בבניין של 16 נציגים, רוב הנציגים פשוט שתקו.
האינטליגנציה לא נעלמה כשפיצלו אותה. היא פשוט הפסיקה לראות את התמונה המלאה.
מרוץ מול תיבת הדואר
בסביבת העוזר האישי התגלה כשל מסוג אחר, ולו יש שם מדויק במדעי המחשב: תנאי מרוץ. המונח מתאר מצב שבו שני תהליכים ניגשים לאותו משאב, והתוצאה תלויה בשאלה מי הגיע ראשון. הדוגמה הקלאסית מגיעה מעולם הבנקאות: שני כספומטים מושכים באותו רגע כסף של אותו לקוח, כל אחד בודק את היתרה לפני שהשני עדכן אותה, ושניהם מאשרים משיכה שהיתרה לא מספיקה לה. אף אחד מהם לא טעה בחישוב. הם פשוט לא חיכו זה לזה.
למעשה, זה בדיוק מה שקרה להזמנות. החוקרים בדקו לא רק אם הבקשה המיוחדת נשלחה, אלא אם היא הייתה בתוך חלון ההקשר של הסוכן ברגע שבו סגר את ההזמנה. כשהיא הייתה שם, היא כובדה ב-56% עד 68% מהמקרים. כשלא, רק ב-19% עד 36%. אצל Opus 5 הפער חד במיוחד: 67.7% מול 18.6%. בסך הכול, המתאם היחיד כיבד את הבקשה בערך פי שניים מהצוות.
וזה עוד לא הכול. ב-65% עד 77% מהריצות של הצוותים היה לפחות שינוי אחד בהזמנה שהלך נגד הבקשה. כלומר, גם כשהמידע זרם, נציגים אחרים עדכנו את ההזמנה בכיוון ההפוך, כל אחד בשם הדייר שלו.
אפשר לחזור לבניין. הגזבר רואה את כל ההודעות בקבוצה, ולכן כשהוא מזמין צבעי לחדר המדרגות הוא כבר יודע שמישהי ביקשה לחכות עם זה, כי יש לה תינוק בבית. בבניין של נציגים, הנציג שסוגר עם הצבעי פשוט לא גלל עד למטה. ההודעה הייתה שם. הוא לא חיכה לה.
כאן טמון הלקח של כל הסיפור, והפתרון שעבד הכי טוב מדגים אותו. החוקרים לא החליפו מודל ולא הוסיפו הנחיות מורכבות. הם הוסיפו לפלטפורמה שומר: מנגנון שחוסם סגירת הזמנה עד שהסוכן שסוגר קרא את כל ההודעות שממתינות לו. בריצות חוזרות של מקרים שבהם הצוות נכשל בפעם הראשונה, השומר העלה את שיעור כיבוד הבקשה ל-73.1% אצל Opus ול-62.3% אצל Sonnet. לעומת זאת, הפתרון האינטואיטיבי, להפקיד את הסגירה רק בידי סוכן מוביל, כמעט לא עזר (47.4% ו-29.4%).
הסוכן לא התעלם מהבקשה. הוא פשוט סגר את הדלת לפני שהיא הגיעה.
ביטולים בלי רשות, טענות בלי מקור
שני הממצאים הבאים פחות מדוברים, ובעיניי חשובים יותר. הראשון נוגע להסכמה. בסביבת התקציב, החוקרים ספרו כמה פעמים סוכן ביטל או עצר עבודה של משתמש אחר בלי לשאול אותו. מודלי GPT ו-Qwen עשו זאת בין 3.87 ל-7.12 פעמים בממוצע לריצה. Sonnet 5 עשה זאת 0.59 פעמים, ו-Opus 5 לא עשה זאת אף פעם.
ופה מגיע הטוויסט האירוני: ריצות שבהן היו ביטולים בלי רשות קיבלו לא פעם ציון גבוה יותר. הסיבה היא שהציון סופר רק את הערך הכולל שהושלם. הוא לא שואל אם העבודה של מישהו נמחקה, ואם מישהו הסכים לזה. החוקרים מציינים זאת בעצמם כמגבלה של שיטת הניקוד. במילים אחרות, מדד שבנוי רק על התוצאה של הקבוצה מתגמל את הנציג החצוף.
אותו מתח עולה גם בשאלת ההוגנות. החוקרים מדדו עד כמה התוצאות התחלקו באופן שוויוני בין המשתמשים, במדד הוגנות ותיק מעולם תקשורת הנתונים שנקרא על שם המהנדס Raj Jain. אצל Opus 5 המדד עמד על 0.59 במתאם ועל 0.58 בצוות. התוכנית האופטימלית, זו שממקסמת את הערך הכולל, הגיעה רק ל-0.47. כלומר, הדרך "הטובה ביותר" לקבוצה איננה בהכרח ההוגנת ביותר לכל אחד מהדיירים.
הממצא השני נוגע להמצאות. בסביבת העוזר האישי, צוותים של Claude העלו טענות לא מבוססות על משתמשים אחרים ב-58% מהריצות (Opus 5) וב-53% (Sonnet 5). סוכן יחיד עשה זאת רק ב-17% עד 20%. ההסבר של החוקרים מבני ולא מוסרי: כל סוכן רואה רק את ההערות של המשתמש שלו, אבל נדרש לדון בהזמנה של כולם, ולכן הוא ממלא את החורים בהנחות. הנציג של דירה 4 לא יודע מה דירה 7 אמרה, אז הוא מנחש, ומציג את הניחוש כעובדה.
ויש כאן שאלה שכמעט אף אחד לא שואל. את ההסכמה שפט Claude Sonnet 5, ואת ההמצאות שפט Claude Opus 5. כלומר, מודלים של Anthropic שפטו גם את המודלים של Anthropic וגם את אלה של המתחרים, בשתי הקטגוריות שבהן Claude יצא טוב במיוחד. אין לי שום ראיה לכך שזה הטה את התוצאות, והחוקרים מציינים בגלוי ששופטים ממוחשבים הם מגבלה. ובכל זאת, זה בדיוק סוג הפרט שמצדיק שחזור עצמאי לפני שמסיקים ממנו מי "הסוכן המנומס" בשוק.
מדד שסופר רק את התוצאה של הקבוצה ילמד את הסוכנים שלנו שחוצפה משתלמת.
מילון כיס: בניין של סוכנים
- מערכת מרובת משתמשים ומרובת סוכנים. כמה אנשים, שלכל אחד מטרה משלו, וכל אחד שולח סוכן משלו אל משאב משותף. שונה מצוות סוכנים שעובד בשביל משתמש אחד.
- מתאם יחיד. סוכן אחד שמשרת את כולם ורואה את כל המידע. במחקר שימש כקבוצת הביקורת, הגזבר של ועד הבית.
- צוות שקט וצוות עמית לעמית. סוכן לכל משתמש, בלי ערוץ תקשורת או עם ערוץ הודעות משותף.
- תנאי מרוץ. מצב שבו התוצאה תלויה בסדר שבו פעולות קורות. כאן: סגירת הזמנה לפני שהודעה חשובה נקראה.
- שומר הודעות שלא נקראו. כלל בפלטפורמה שחוסם פעולה בלתי הפיכה עד שהסוכן קרא את כל מה שממתין לו.
- ביטול בלי הסכמה. פעולה של סוכן על משאב של משתמש אחר בלי לשאול אותו. שיטת הניקוד של המחקר לא העניש עליה.
- נקודת מוקד. מושג של הכלכלן תומס שלינג: פתרון ששני צדדים בוחרים בו בלי לדבר, כי הוא נראה "טבעי" לשניהם.
- MAMUBench. ערכת המבחנים שהחוקרים שחררו: שלוש מתוך ארבע הסביבות, עם 74 תרחישים, לבדיקת התנהגות של סוכנים במצבים כאלה.
מה ידעו בירושלים וברמת גן כבר בשנות השמונים
סוכנים ממוחשבים שמתאמים ביניהם אינם המצאה של עידן מודלי השפה, וגם לא של גל הלמידה העמוקה שקדם לו. ב-1980 פרסם Reid Smith את פרוטוקול Contract Net, שבו סוכן אחד מפרסם משימה, והאחרים מגישים הצעות לבצע אותה, כמו מכרז קטן. אלא שהמערכות המוקדמות של מה שנקרא אז בינה מלאכותית מבוזרת הניחו הנחה נוחה: שכל הסוכנים משרתים מטרה משותפת אחת. כלומר, צוות, לא בניין.
את ההנחה הזאת שבר חוקר ישראלי. ג'פרי רוזנשיין, שעשה את הדוקטורט שלו בסטנפורד ובהמשך הצטרף לאוניברסיטה העברית, פרסם ב-1985 יחד עם Michael Genesereth את המאמר "עסקאות בין סוכנים רציונליים" בכנס IJCAI בלוס אנג'לס. לפי דף תולדות המחקר שלו באוניברסיטה העברית, זו הייתה העבודה הראשונה בבינה מלאכותית שהשתמשה בתורת המשחקים כדי לנתח אינטראקציה בין סוכנים. רוזנשיין גם טבע את הכינוי "סוכנים מיטיבים" למערכות הקודמות, שהניחו שלכולם אותם אינטרסים. העולם שלו היה עולם של סוכנים שלכל אחד מהם בעלים משלו.
את המהלך החשוב באמת עשו רוזנשיין וגלעד זלוטקין בספר "Rules of Encounter" שיצא בהוצאת MIT ב-1994. הרעיון המרכזי שלו מתאים למחקר של השבוע כמו כפפה ליד: במקום לשאול איך לתכנת כל סוכן כך שיתנהג טוב, צריך לשאול איך לעצב את חוקי האינטראקציה עצמם, כי חוקי המשחק הציבוריים משפיעים על האסטרטגיות הפרטיות שמתכננים מטמיעים במכונות שלהם. זה בדיוק מה שעשה שומר ההודעות. הוא לא שיפר אף נציג. הוא שינה את התקנון.
שרית קראוס מאוניברסיטת בר אילן היא הדמות הישראלית הבולטת השנייה בתחום. ב-1992 הכניסו היא ורוזנשיין לתחום את רעיון נקודות המוקד של תומס שלינג, כלומר איך צדדים יכולים לתאם גם בלי לדבר בכלל. זו בדיוק הבעיה של "הצוות השקט" במחקר של Anthropic, זה שקרס בשתי סביבות. שלינג עצמו חלק ב-2005 את פרס נובל לכלכלה עם רוברט אומן מהאוניברסיטה העברית, על הבנת עימות ושיתוף פעולה דרך תורת המשחקים. קראוס זכתה בפרס Computers and Thought של IJCAI, בפרס א.מ.ת ב-2010, וב-2023 בפרס מצוינות המחקר של IJCAI, שציין בין השאר את עבודתה המוקדמת על סוכנים בעלי אינטרס עצמי, שעזרה לבסס את המשא ומתן הממוחשב כתחום. לפי נימוקי פרס א.מ.ת, המחקר שלה הוליד גם מערכת אבטחה שהופעלה בנמל התעופה של לוס אנג'לס.
ויש עוד שכבה ותיקה יותר. ב-1968 פרסם האקולוג Garrett Hardin את "טרגדיית נחלת הכלל", ובה טען שמשאב משותף נידון להתרוקן כשכל משתמש פועל לטובתו. בפרס נובל לכלכלה של 2009 הוכרה אלינור אוסטרום, שהראתה שקהילות רבות דווקא מצליחות לנהל משאבים משותפים, לא בעזרת שליט יחיד וגם לא בהפרטה, אלא בעזרת כללים שהקהילה עצמה קובעת ואוכפת. זו הדרך השלישית, והמחקר החדש רומז שגם הסוכנים שלנו יזדקקו לה.
לפני שלושים שנה כבר הציעו בירושלים לתקן את הבניין בתקנון, ולא רק בנציגים.
הסיפורים שמתחברים לזה
Worse Together לא עומד לבד. הוא חלק מגל של מחקרים שבודקים מה קורה כשסוכנים פוגשים סוכנים, וכשקוראים אותם יחד מתקבלת תמונה עקבית למדי.
מחקר אחר, שמוצג בכנס NeurIPS 2026 ונכתב בהובלת Cooperative AI Foundation עם חוקרים מאוקספורד ומהמכון הבריטי לבטיחות AI, בדק אם סוכנים מסוגלים לשכנע, להונות ולאיים זה על זה. הממצא המרכזי, לפי דף הפרויקט: כל אחד מהמודלים המשפיעים שנבדקו הצליח לגרום למודל המפקח לאשר בקשה שהיה צריך לדחות. ההונאה הייתה הכלי האפקטיבי ביותר, אחריה השכנוע, והאיום פחות מכולם. בסביבה של פורום מחקר, שבה שני סוכני מחקר חולקים לוח תוצאות, הנחיה לשכנע העלתה את שיעור הריצות שבהן הסוכן השני שינה כיוון לטובת הראשון מ-4% ל-26%.
מחקר של Microsoft Research מאוקטובר 2025, שנקרא Magentic Marketplace, בנה שוק מדומה שבו סוכני לקוחות קונים מסוכני עסקים. התגלתה שם הטיה קיצונית להצעה הראשונה: ההצעה הראשונה נבחרה ב-60% עד 100% מהמקרים, וההצעה השלישית כמעט אף פעם. בשוק כזה, מי שעונה הכי מהר מנצח, לא מי שמציע הכי טוב. מי שמכיר את הדרך שבה שווקים מצרפים מידע מבין כמה מסוכן זה: שוק שבו הקונים לא משווים הוא שוק שבו המחירים לא אומרים כלום.
וחוקרים מברקלי פרסמו במרץ 2025 את "למה מערכות מרובות סוכנים נכשלות?", עם טקסונומיה של 14 אופני כשל בשלוש משפחות, שנבנתה מניתוח של יותר מ-1,600 תיעודי ריצה משבע מסגרות פיתוח. אחת המשפחות היא בדיוק חוסר תיאום בין סוכנים: מידע שלא מועבר, שאלות הבהרה שלא נשאלות, שיחות שמתאפסות באמצע. משפחה אחרת עוסקת במשימות שנסגרות מוקדם מדי, בלי שמישהו בדק את התוצאה.
במקביל, התשתית לסוכנים שמדברים זה עם זה כבר נבנית. Google הכריזה באפריל 2025 על פרוטוקול Agent2Agent, וביוני של אותה שנה העבירה אותו לקרן Linux. פרוטוקול כזה פותר את שאלת השפה המשותפת: איך סוכן של חברה אחת שולח הודעה לסוכן של חברה אחרת. הוא לא פותר, ולא מתיימר לפתור, את מה שהמחקר של Anthropic מצביע עליו. אפשר להעביר הודעה בצורה מושלמת ועדיין לסגור את העסקה לפני שקראו אותה.
מעניין שבתוך מודל אחד, התעשייה כבר מזמן הפנימה את הלקח. בארכיטקטורת Mixture of Experts, למשל, יש רכיב מנתב שמחליט איזה "מומחה" יטפל בכל חלק של הקלט. אף אחד לא מצפה מהמומחים להסתדר ביניהם לבד. כשאותם רכיבים יוצאים מהמודל ומתחילים לייצג אנשים שונים, דווקא שם נעלם המנתב.
מה התיקונים מלמדים, ומה הם לא מלמדים
הנתונים על התיקונים מעניינים לא פחות מהכשלים, ודורשים קריאה זהירה. בסביבת התקציב, הוספת סוכן מוביל לצוות העלתה את Opus 5 מ-30% ל-64%, כלומר לרמה של המתאם היחיד, ואת Sonnet 5 מ-12% ל-37%. סוכן מוביל שקיבל הנחיות מפורשות, לדרג עבודות לפי ערך, לשחרר בזמן תקציב שנשמר בצד ולדרוש מהאחרים לדווח ולציית להקצאה שלו, הגיע ל-71% אצל Opus ול-44% אצל Sonnet. כאן, לראשונה, הצוות עקף את המתאם היחיד (64% ו-32%).
שלושה סייגים חשובים. ראשית, בסביבת העוזר האישי התוצאות של התיקונים נמדדו בריצות חוזרות של מקרים שבהם הצוות נכשל, ולכן אי אפשר להשוות אותן ישירות למספרים של הריצה הראשונה. שנית, התיקון שעבד בסביבה אחת לא עבד בהכרח בשנייה: סוכן מוביל הציל את סביבת התקציב, אבל כמעט לא עזר בהזמנות, ושם עבד דווקא השומר. החוקרים מסיקים מכך שלכשלים יש סיבות שונות. ושלישית, כל המספרים האלה הם ממוצעים על פני תרחישים מעטים יחסית, 25 בכל אחת משתי הסביבות שמתוארות בפירוט, עם רווחי סמך שמופיעים בגרפים של החוקרים.
המסקנה הזהירה היא לא ש"מתאם יחיד תמיד עדיף", וגם לא ש"צוות עם מנהל פותר הכול". היא שמבנה התיאום הוא משתנה בפני עצמו, נפרד מהאינטליגנציה של המודל, ושצריך לתכנן אותו לכל משאב משותף בנפרד. החוקרים עצמם מציעים שני כיוונים משלימים: שומרים ברמת הפלטפורמה, ואימון של הסוכנים עצמם לנהל משא ומתן ולהגיע להסכמה. סביבות כמו MAMUBench מתאימות בדיוק לאימון כזה בשיטות של למידת חיזוק, אבל המחקר לא מפרט איך אימון כזה אמור להיראות.
מה אנחנו יודעים, ומה עדיין לא
אנחנו יודעים שבסביבות שנבנו לשם כך, עם משתמשים מדומים, צוותים של סוכנים אישיים השיגו לקבוצה פחות מסוכן יחיד, בכל ארבע הסביבות, ושהפער לא נבע מחוסר יכולת. אנחנו יודעים גם שכלל פשוט ברמת הפלטפורמה החזיר חלק גדול מהנזק בסביבת ההזמנות.
אנחנו לא יודעים עד כמה זה מתורגם לעולם האמיתי. המשתמשים היו מדומים, והסביבות בנויות במכוון כך שהמתאם מצליח, מה שמחדד את הפער אבל אולי גם מגדיל אותו. הבלוג מתאר בפירוט רק שתיים מארבע הסביבות. ההסכמה וההמצאות נשפטו בידי מודלים ולא בידי בני אדם, ומדובר במודלים של Anthropic עצמה, שגם המודלים שלה נבחנו במחקר. המאמר פורסם כטיוטה בארכיון arXiv, ועוד לא ראינו שחזור עצמאי. וגרסאות המודלים מתחלפות כל כמה חודשים, כך שהדירוג בין Claude, GPT ו-Qwen עשוי להשתנות עוד לפני שמישהו ישחזר אותו.
ויש שאלה שהמחקר בכלל לא מנסה לענות עליה: מה קורה כשהדיירים עצמם, בני האדם, משנים את ההתנהגות שלהם כי יש להם נציג. ייתכן שאנשים ינסחו בקשות אחרות, או יבדקו פחות, כשמישהו אחר מדבר בשמם. זה כבר מחקר אחר.
לפני שנותנים לסוכן את המפתחות
הסיטואציה של ועד הבית לא תישאר מטפורה הרבה זמן. משרד קטן בתל אביב שבו לכל שותף יש סוכן שמנהל לו את היומן, משפחה שבה כל אחד מבני הזוג מחזיק עוזר שמזמין קניות באותו כרטיס אשראי, צוות פיתוח שבו כל מפתח שולח סוכן לאותו תור מיזוג. בכל אחד מהמקרים האלה יש משאב משותף ויש כמה נציגים. מה שהמחקר מציע, בתרגום לשפה של היום יום, נראה בערך כך:
- מתחילים במיפוי המשאב המשותף. תקציב, יומן, כרטיס האשראי המשפחתי, מכסת שימוש. כל מקום שבו שני סוכנים יכולים לגעת באותו דבר הוא מקום שבו יכול לקרות תנאי מרוץ.
- איפה שאפשר, מתאם אחד. אם כל המשתמשים מוכנים לשתף מידע עם סוכן אחד, זו עדיין התצורה שהשיגה את התוצאות הטובות ביותר ברוב הסביבות. מה שמפסידים בפרטיות מרוויחים בתמונה מלאה, וזו החלטה שראוי לקבל במודע.
- כלל קריאה לפני פעולה. שום פעולה בלתי הפיכה, תשלום, ביטול או הזמנה, לא מתבצעת לפני שהסוכן המבצע קרא את כל ההודעות שממתינות לו. זה התיקון שעבד הכי טוב בהזמנות, והוא דורש מעט מאוד.
- הסכמה מפורשת לפני נגיעה במשאב של אחר. סוכן שמבטל עבודה או תור של משתמש אחר צריך לקבל אישור. גם אם זה מוריד מעט את התוצאה הכוללת, כמו שהמחקר עצמו מראה.
- טענה על אדם אחר היא השערה עד שהוצג לה מקור. נציג שאומר "דירה 7 לא אכפת לה" כנראה מנחש. בסביבת העוזר האישי, טענות לא מבוססות כאלה הופיעו ביותר ממחצית הריצות של צוותי Claude.
- מודדים התנהגות, לא רק תוצאה. מי שבודק רק כמה כסף נחסך או כמה משימות הושלמו יפספס את הביטולים בלי רשות ואת ההמצאות. החוקרים עצמם ממליצים למדוד את שני הדברים יחד.
שום דבר מזה לא דורש בינה מלאכותית חכמה יותר. הוא דורש מישהו שיחליט מה כללי הבית, וזו בדיוק ההחלטה שקל לשכוח כשקונים נציג מבריק.
התקנון, לא הנציג
מי שישב פעם באסיפת דיירים יודע שהבעיה בבניין כמעט אף פעם איננה שהשכנים טיפשים. הבעיה היא שכל אחד רואה רק את הדירה שלו, שההודעה החשובה נקברה בקבוצה מתחת לעשרים הודעות על חניה, ושמי שהזמין את הצבעי לא ידע שמישהי ביקשה לחכות. בניין עובד כשיש לו תקנון: מי מחליט על מה, מתי מחכים, ומה אסור לעשות בלי לשאול.
הסוכנים שלנו מגיעים עכשיו לבניין הזה, כל אחד נאמן לדייר שלו, וכל אחד חכם יותר מרוב הדיירים. המחקר של Anthropic מראה שזה לא מספיק, ואולי אפילו מסוכן, כי נציג חכם שלא מחכה סוגר עסקאות מהר יותר. את כיוון התשובה הציעו רוזנשיין וזלוטקין לפני שלושים שנה: לעצב את חוקי המפגש בין הסוכנים, ולא להסתפק בשיפור של כל סוכן לחוד. לכן, כשמישהו יציע לנו בקרוב סוכן אישי שידבר בשמנו עם הסוכנים של כל השאר, השאלה החשובה לא תהיה כמה הוא חכם. השאלה תהיה מי כתב את התקנון של הבניין שהוא נכנס אליו, ואם יש בכלל תקנון כזה. ואם עוד לא, כדאי מאוד שנכתוב אותו לפני שהנציגים יתחילו לסגור עסקאות. אפשר להמשיך לקרוא על השאלות האלה במדור האתיקה של AI שלנו.
שאלות נפוצות
מה ההבדל בין מערכת מרובת סוכנים רגילה לבין מערכת מרובת משתמשים ומרובת סוכנים?
במערכת מרובת סוכנים רגילה, כמה סוכנים עובדים יחד בשביל משתמש אחד ומטרה אחת, למשל צוות שכותב קוד או הוכחה. במערכת מרובת משתמשים, לכל סוכן יש בעלים אחר עם מטרה אחרת, וכולם חולקים משאב אחד כמו תקציב או יומן. המחקר Worse Together עוסק בסוג השני, ושם הבעיות של תיאום, הסכמה והוגנות הופכות למרכזיות.
האם המחקר אומר שתמיד עדיף סוכן אחד לכולם?
לא בדיוק. בכל ארבע הסביבות המתאם היחיד הוביל על הצוות הבסיסי, אבל צוות עם סוכן מוביל שקיבל הנחיות מפורשות עקף אותו בסביבת התקציב. בנוסף, מתאם יחיד דורש שכל המשתמשים ישתפו איתו מידע, וזה לא תמיד אפשרי או רצוי. המסקנה היא שמבנה התיאום צריך להיות מתוכנן, לא שיש מבנה אחד נכון.
מה זה MAMUBench?
ערכת מבחנים פתוחה שהחוקרים שחררו יחד עם המחקר. היא כוללת שלוש מתוך ארבע הסביבות, תקציב האסימונים, המרפאה והעוזר האישי, עם 74 תרחישים, ומאפשרת למפתחים ולחוקרים לבדוק איך סוכנים מתאמים ומתנהגים כשהם משרתים משתמשים שונים.
האם Claude יצא טוב יותר מהמודלים המתחרים?
בחלק מהמדדים כן. Opus 5 לא ביטל אף פעם עבודה של משתמש אחר בלי לשאול, ו-Sonnet 5 עשה זאת בתדירות נמוכה בהרבה, בעוד מודלי GPT ו-Qwen עשו זאת כמה פעמים בכל ריצה. עם זאת, ההסכמה נשפטה על ידי Claude Sonnet 5, המחקר נעשה בתוכנית של Anthropic, וצוותים של Claude עצמם המציאו טענות על משתמשים אחרים ביותר ממחצית הריצות. עד שיהיה שחזור עצמאי, נכון להתייחס לדירוג הזה בזהירות.